그럴듯함은
근거가 아니다.
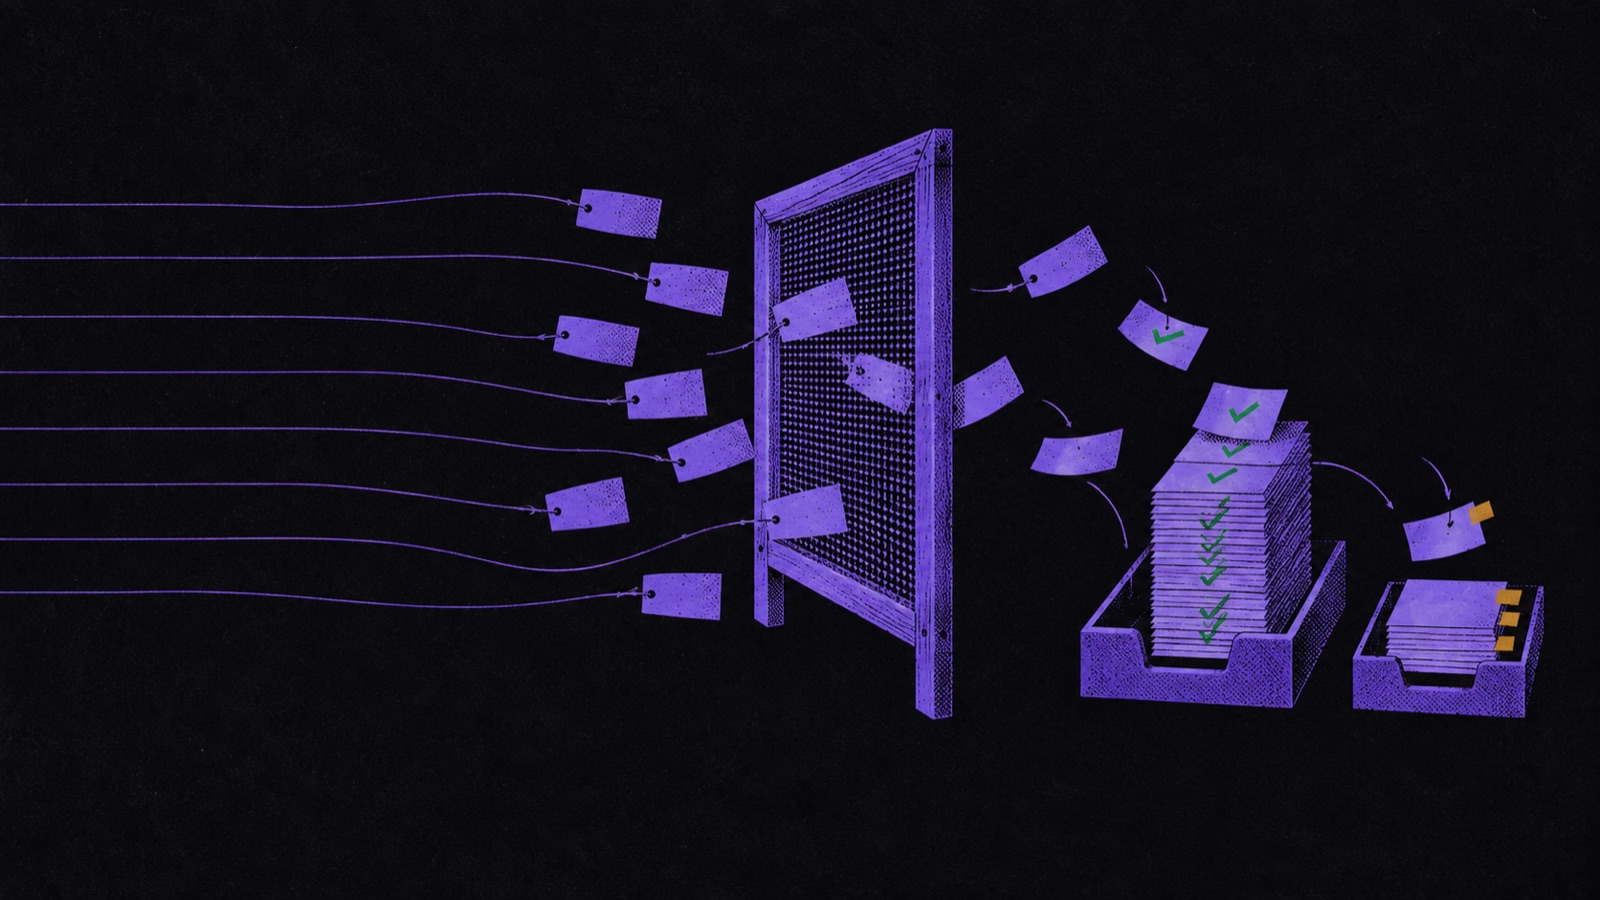
질문 하나를 주면 에이전트 여럿이 웹과 학술 자료를 동시에 조사해 인용이 달린 리포트로 정리합니다. 모든 출처에 A~E 등급을 매기고, 두 곳 이상에서 확인되지 않은 주장은 본문 대신 부록으로 보냅니다.
/plugin marketplace add https://github.com/fivetaku/gptaku_plugins.git
/plugin install insane-research@gptaku-plugins
터미널에서 `claude plugin marketplace add fivetaku/gptaku_plugins`와 `claude plugin install insane-research@gptaku-plugins`를 실행해 설치해 줘. 끝나면 Claude Code를 재시작하라고 알려줘.
8에이전트
109출처
42 / 32본문 / 부록
아래 샘플 리포트 한 건의 실제 수치입니다.
질문 하나가 리포트가 되기까지
실제 리서치 세션(2026-08-23)의 기록을 재생한 화면입니다.
검사는 코드가 합니다
주장마다 출처를 장부에 적고, validate_ledger.py가 그 장부를 검사합니다. 통과하지 못하면 리포트 단계로 넘어가지 않습니다. 모델이 "확인했다"고 말하는 것만으로는 부족합니다.
샘플 리포트
실제 산출물Claude Code 멀티세션 앱 번들 ID와
Claude Code 멀티세션 앱 번들 ID와
Windows 알림 구현 방법
우리 알림 플러그인을 만들 때 실제로 쓴 리포트를 고치지 않고 공개합니다.
원문 보기 →솔직하게
개요만 빨리 필요하면 ChatGPT나 Gemini의 딥리서치가 더 편합니다. insane-research는 질문을 몇 개 되묻고 시간도 더 걸립니다. 기술 선택, 구현 근거, 숫자처럼 틀리면 손해가 큰 결정에 쓰세요.
틀리면 손해가 큰
결정 앞에서.
/plugin marketplace add https://github.com/fivetaku/gptaku_plugins.git
/plugin install insane-research@gptaku-plugins
터미널에서 `claude plugin marketplace add fivetaku/gptaku_plugins`와 `claude plugin install insane-research@gptaku-plugins`를 실행해 설치해 줘. 끝나면 Claude Code를 재시작하라고 알려줘.